分类、二分类与回归 从场景对接到人工智能基础软件开发
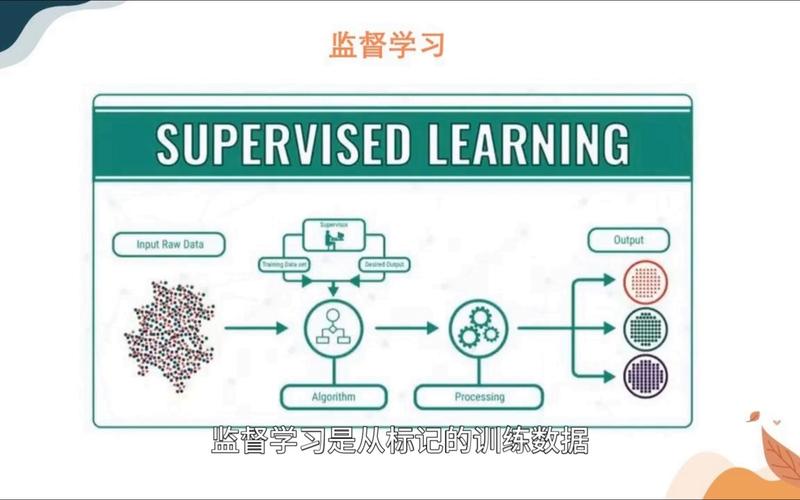
在人工智能基础软件开发中,理解机器学习任务的类型是构建正确软件架构的前提。分类、二分类和回归是三种最常见的监督学习任务,它们对应着不同的现实场景,也驱动着软件测试与测试开发策略的差异。
一、任务定义与核心区别
分类问题:目标变量是离散的类别标签,类别数大于等于2。例如,将邮件标记为“垃圾邮件”“工作邮件”“社交邮件”。
二分类问题:分类问题的特例,目标只有两个互斥类别。例如,判断交易是否为欺诈(是/否),或病人是否患病(阳性/阴性)。
回归问题:目标变量是连续数值。例如,预测房屋价格、股票走势或温度。
三者的本质区别在于输出空间:分类输出有限集合,回归输出实数域。这一区别决定损失函数的选择(交叉熵 vs 均方误差)、模型评估指标(准确率、F1 vs MAE、RMSE)以及软件系统的阈值处理逻辑。
二、对应场景与软件测试视角
1. 二分类场景
典型应用:信用评分、垃圾邮件过滤、疾病初筛。
软件测试重点:由于二分类常涉及敏感决策,测试开发需要关注阈值边界测试——改变分类阈值对假阳性/假阴性的影响。类别不平衡下的测试数据构造与模型漂移监控是关键。例如,在银行卡反欺诈系统中,测试开发必须验证当欺诈样本仅占0.1%时,模型的召回率是否达到业务要求。
2. 多分类场景
典型应用:图像识别(猫/狗/鸟)、文本情感分析(正面/中性/负面)。
软件测试重点:混淆矩阵的细粒度测试——每个类别的精确率、召回率均需验证。测试开发需要自动化生成每类样本的高覆盖率数据集,并检查模型对类别标签顺序的鲁棒性。
人工智能基础软件开发中,则常需设计多分类的输出适配层,如Softmax函数与交叉熵损失的接口测试。
3. 回归场景
典型应用:房价预测、销量预测、传感器校准。
软件测试重点:连续输出的容差范围测试。单点误差测试无法覆盖数值型的偏差传播。测试开发需构建分布式测试集——覆盖目标值范围的不同区段(高、中、低数值域),评估模型在全域上的残差分布。软件层面还需验证连续数值格式化、缺失值填充和异常值处理逻辑。
三、人工智能基础软件开发中的任务桥梁
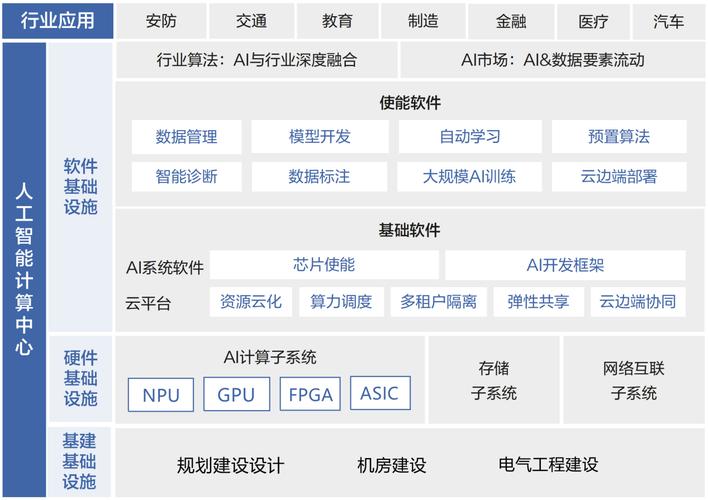
在AI基础软件(如推理引擎、模型服务框架)中,同一套API常需要同时支持分类和二分类。常见的测试开发场景包括:
- 概率输出到标签的转换门限管理。基础设施须提供可配置的决策阈值,并确保二分类下输出维度的压缩正确。
- 混合模型服务:回归模型用于特征工程、分类模型用于最终裁决时,测试需要确认两者接口的数据类型对齐(浮点传导 vs 标签传递)。
- 端到端流水线测试:上游回归模型输出连续系数,下游二分类模型使用方法阈值化。此类嵌套结构必须在测试开发阶段被发现结构偏差。
深度学习普及后,基础软件更将这三类问题垂直解耦为不同“列”(column)接口的设计。测试开发人员反向安装自动化集成用例,推导出真实运行中对所有定义空间的基本分离测试。
四、小结
分类(含二分类)和回归看似只有“离散”与“连续”之差,但在实际AI基础软件开发中,二者导致明显不同的依赖构建和数据校验行为。测试开发的挑战并非验证单一模型的精度指标,而从完整方案生态以及底样算法接口定义入手统一鉴别,平衡数据态和阈值态带来的所有干扰同集异动。清晰分离二者及相关子类型,已经成为未来人工智能软件体系更加智能重构与追溯的基础要求。
如若转载,请注明出处:http://www.bxtsu.com/product/44.html
更新时间:2026-10-11 19:35:29